SEERAVERSE RH 项目:用于可审计证明搜索的元方法论
SEERAVERSE RH 项目:用于可审计证明搜索的元方法论
本文提出了一种“元方法论”,旨在管理长期且复杂的数学证明探索过程,如黎曼猜想(RH),使其不仅仅停留在给出结论,而是将整个探索过程本身作为一个可审计、可恢复和可重用研究资产来管理。其目标不仅是发现数学真理,更是系统化地构建一个架构,用于组织从思考路径、假设生成、反证到知识积累的整个思维流程,从而实现人类与AI的协同探索。
问题设定:长期证明搜索中的可审计性缺失
现代高级数学证明往往依赖于大量等价变换、复杂的假设以及深刻的直觉。在这样的长期迭代探索过程中,传统的数学方法或计算机验证技术面临以下挑战。
- 路径丢失:在推导出结论的过程中尝试的各种逻辑分支和基于失败假设积累的知识很容易丢失,难以重用。
- 重复搜索:对同一逻辑空间或等价问题的反复探索会不断发生,导致效率低下。
- 因果关系模糊:无法清晰追踪是哪个推理或假设促成了最终结论,或者哪一个分支决定性地失败了,缺乏明确的因果链条。
- 有限验证的模糊性:即使采用区间运算或任意精度计算等有限验证手段,如何从元层面评估这些结果对整个探索空间的可靠性担保,缺乏相应的标准和依据。
这些挑战表明,有必要将证明搜索重新理解为知识和假设的动态网络,而不仅仅是推论的链条。
提出的探索架构
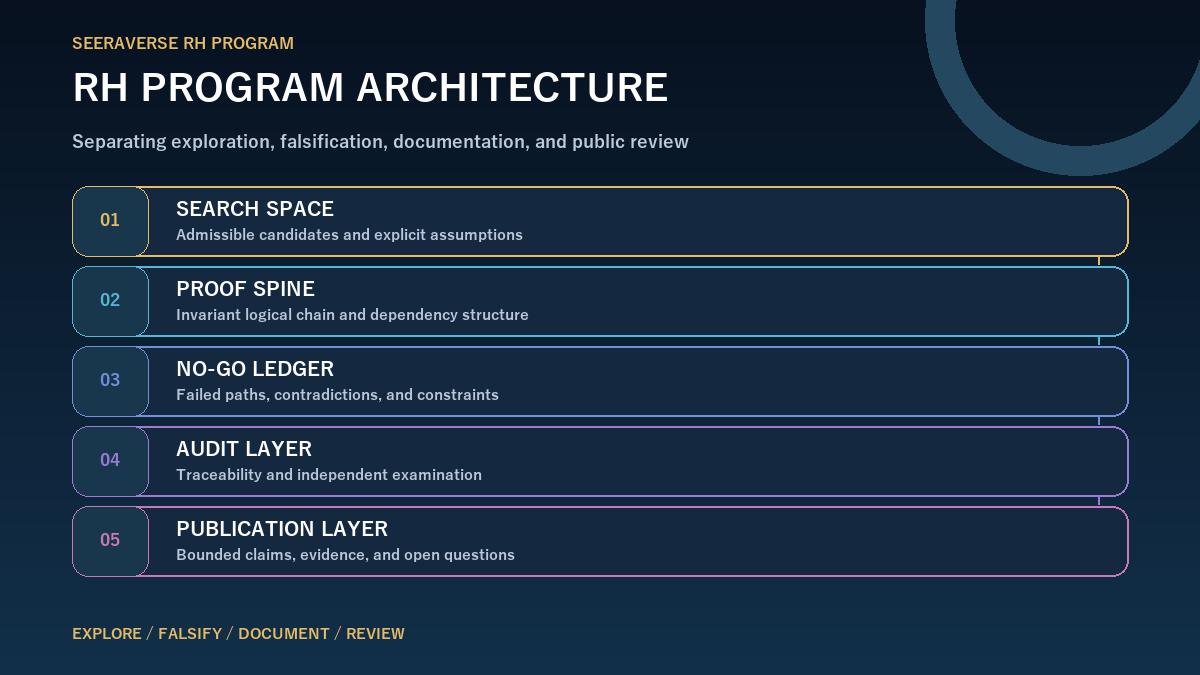
本元方法论提出了一种由以下主要组成要素构成的探索架构,以实现长期探索的可审计性和可恢复性。该架构旨在将数学论证的“骨架”和“历史记录”分离,从而结构化知识的管理。
Invariant proof spine(不变量证明脊椎)
定义贯穿整个研究过程中不会改变的逻辑和概念骨架。它是关于最终目标或本质数学对象的基本前提和结论结构,无论探索多么复杂,该“脊椎”都保持固定。所有的探索路径必须沿着这个不变的骨架进行。
One-live-lock / one-next-move(单一当前锁定/下一步动作)
在每个探索步骤中,明确识别当前面临的主要逻辑障碍(即“锁定”)和需要验证的具体行动(即“下一步动作”)。这有助于聚焦搜索焦点,防止非高效的分支。
No-Go ledger(禁止路径台账)
记录那些因失败的逻辑分支或反证结果而停滞或无效的路径。该台账不仅仅是错误日志,而是被视为“负知识”,作为约束条件发挥作用,防止重复进行相同的探索。这消除了探索空间中的冗余性,并使资源能够分配到新的方向。
Equivalence-preserving compression(同值性保持压缩)
当使用多个不同的逻辑表达或等价变换处理问题时,追踪其重新表述是否保留了关于原始问题的核心信息。它定量评估证明责任是否实质性缩小,从而实现非高效冗余的压缩。
GCD/LCM analysis(最大公约数/最小公倍数分析)
分离并分析多个不同论证或假设群共有的最小逻辑核(即GCD),以及为达成目标额外必需精化条件的集合(即LCM)。这使得抽象结构与具体的数值或概念细节得以清晰区分,从而只汇集必要的信息。
Truth by Shadow(影式真理)
对于难以直接处理的对象或复杂结构,确立使用可审计的“影子”或“投影”来验证其本质而不扭曲的方法。这是一种在达到完整证明之前,通过外部观察确认部分真理的方法。
数学与计算机验证的边界
本方法论明确区分了定性数学论证(概念洞察)和实际的常数评估或机器辅助有限验证(计算验证)。特别是在使用区间运算、Krawczyk法、任意精度球运算等计算技术时,不应将这些结果模糊地视为经验证据,而必须将其纳入为探索空间内的“有限门槛”(Finite Gate)。这些计算工具并非用于认证最终证明的真理本身,而是用来验证特定逻辑步骤是否满足的要求。
有限验证的作用
上述有限验证手段在探索过程中提供的是关于某一假设是否处于可接受范围内的“有限性认证”。这种认证并不能停止探索,而是作为推进到下一步所需的约束条件。
人类与AI的协同:知识生成与验证系统
本架构设想了一个人类和AI分担不同角色的协作环境。人类负责承担“不变量证明脊椎”和“影式真理”等高阶的概念判断和最终责任。一方,AI则负责生成可审计的历史记录和提高效率,例如记录“禁止路径台账”、进行探索空间的全面搜索、自动生成同值变换,以及基于“GCD/LCM分析”确定结构性关联。
- AI的角色:假设候选的生成、反证路径的自动探索、失败分支的记录、通过同值变换进行的压缩。
- 人类的角色:定义逻辑骨架(不变量证明脊椎)、进行元层面的判断(哪些失败应作为负知识保留)、对最终真理进行解释和承担责任所在。
AI的输出不会直接成为结论,而是被转化为可审计的探索历史记录,从而保证了其可靠性。这使得AI成为提高搜索效率的工具,而人类则维持对整个探索过程的负责权。
适用范围与局限性
适用范围
本元方法论不仅适用于黎曼猜想这类特定的证明问题,也适用于任何具有巨大探索空间、大量同值变换、容易发生中间步骤丢失或重复搜索的其他数学和理论研究。它可作为知识管理框架,应用于人类与AI共同进行假设生成、反证、记录和验证的所有研究环境。
局限性与未解决问题
本方法论提供的是一个使探索过程可审计的框架,而非证明数学结论本身。因此,其适用范围仅限于“结构化搜索”。尚未解决的问题包括:
- 元层面的评估标准:如何建立客观的标准来判断哪些失败分支应作为负信息保留(即设置No-Go ledger的记录阈值)。
- 真理的定义:如何从探索历史合理地收敛到最终“真理”,包括非定型的逻辑飞跃和直觉的引入方法。
- AI责任的范围:严格界定可审计结果与人类责任的边界,并构建社会实践中的法律和伦理框架。
将探索记录视为研究资产
本方法论的关键在于不将完成的证明视为唯一的成果。在长期探索中,某个路径为何无法成立、置入何种假设会导致转向另一个问题、以及从哪个阶段需要计算机确认,这些信息本身就是支持下一步判断的重要依据。如果能附带理由保存失败的分支,可以避免将来重复走同样的路径。此外,当获得新的工具或视角时,它也可以成为重新评估过去已关闭分支的依据。
这里的可审计性并非指将研究替换为机械化的检查清单。它指的是使第三方或未来的研究人员能够追踪到:哪个论断源于定义、在哪里使用了辅助假设、哪些部分尚未证明、以及计算结果仅保证了何种范围。其目的不是排除直觉和发现性的灵感,而是建立一个记录这些灵感作用于证明责任的框架。
区分同值表述与实质性进展
在困难的问题中,可能用不同的记法或领域的语言表达相同的内容。重新构建(re-formulation)可以成为引入新工具的入口,但有时仅仅是改变了表达方式,而未解决的部分依然存在。本预印本强调的不是表述的新鲜度,而是确认剩余的证明责任是否确实缩小了。
因此,记录转换前后哪些内容被保留、哪些内容构成了附加条件、以及哪些未解决点仍然存在至关重要。通过将共通于多个路径的逻辑核与仅在单个路径所需的额外精化条件区分开来,可以提高探索的可预见性。这种整理不会自动保证证明的正确性,但它明确了进步的判定标准,并降低了以别名重复处理同一问题的风险。
何时放置有限验证
区间运算、Krawczyk法和任意精度球运算并非能凭空证明无限延伸的数学命题的神奇方法。它们是在通过解析论证将问题降维到明确有限条件时,用于确认这些条件的手段。因此,在使用有限验证之前,必须清晰地界定待检查对象、区间、精度、误差边界、重新计算步骤,以及从有限确认回到整体主张的逻辑链条。
本预印本将“不模糊化此边界”作为方法论的一部分。它将定性数学、明确常数的导出和机器进行的有限确认记录为不同的层次,避免仅凭计算结果就称之为证明。本文展示的不是经过认证的RH证明,而是接近这种严格的有限门槛时所需要的管理原则。
阅读本文件时的检查点
- 哪些部分属于普遍的研究方法论,哪些部分是以RH为题材的具体案例。
- 不变量逻辑骨架与更新的工作假设是否分离。
- 失败的分支不仅保存了结论,还保存了理由。
- 重新构建后,剩余的证明责任是否确实缩小了。
- 数值计算保证的有限范围和解析论证承担的范围是否区分开来。
这些是评估本方法论有效性的检查点,并不意味着方法论本身已经完善。未来还需要在实际探索历史中验证哪些单位应该被记录、如何在不同研究人员或AI系统之间比较记录,以及如何审计台账的更新规则等操作层面的验证。
参考文献信息
原题:SEERAVERSE RH Program: A Meta-Methodology for Auditable Proof Search Around the Riemann Hypothesis
文档类型:预印本 (Preprint)
发布日期:2026年10月2日
发布者:SEERAVERSE 研究小组
收录语言:日语・英语
DOI:10.5281/zenodo.23101473
您可以在Zenodo的记录页面查看日语版PDF和英文版PDF。